「模型映射」页的每一条 = ChatGPT.app 模型选择器里的一个条目。它指向供应商里的某个 上游模型,并可以覆盖上下文窗口与生成参数。
这样设计的好处在细节里:同一个上游模型可以暴露成多个条目(「省流 32K」与「满窗口」各一条), 窗口与参数跟着条目走,换上游端点也不影响你已经配好的形态。
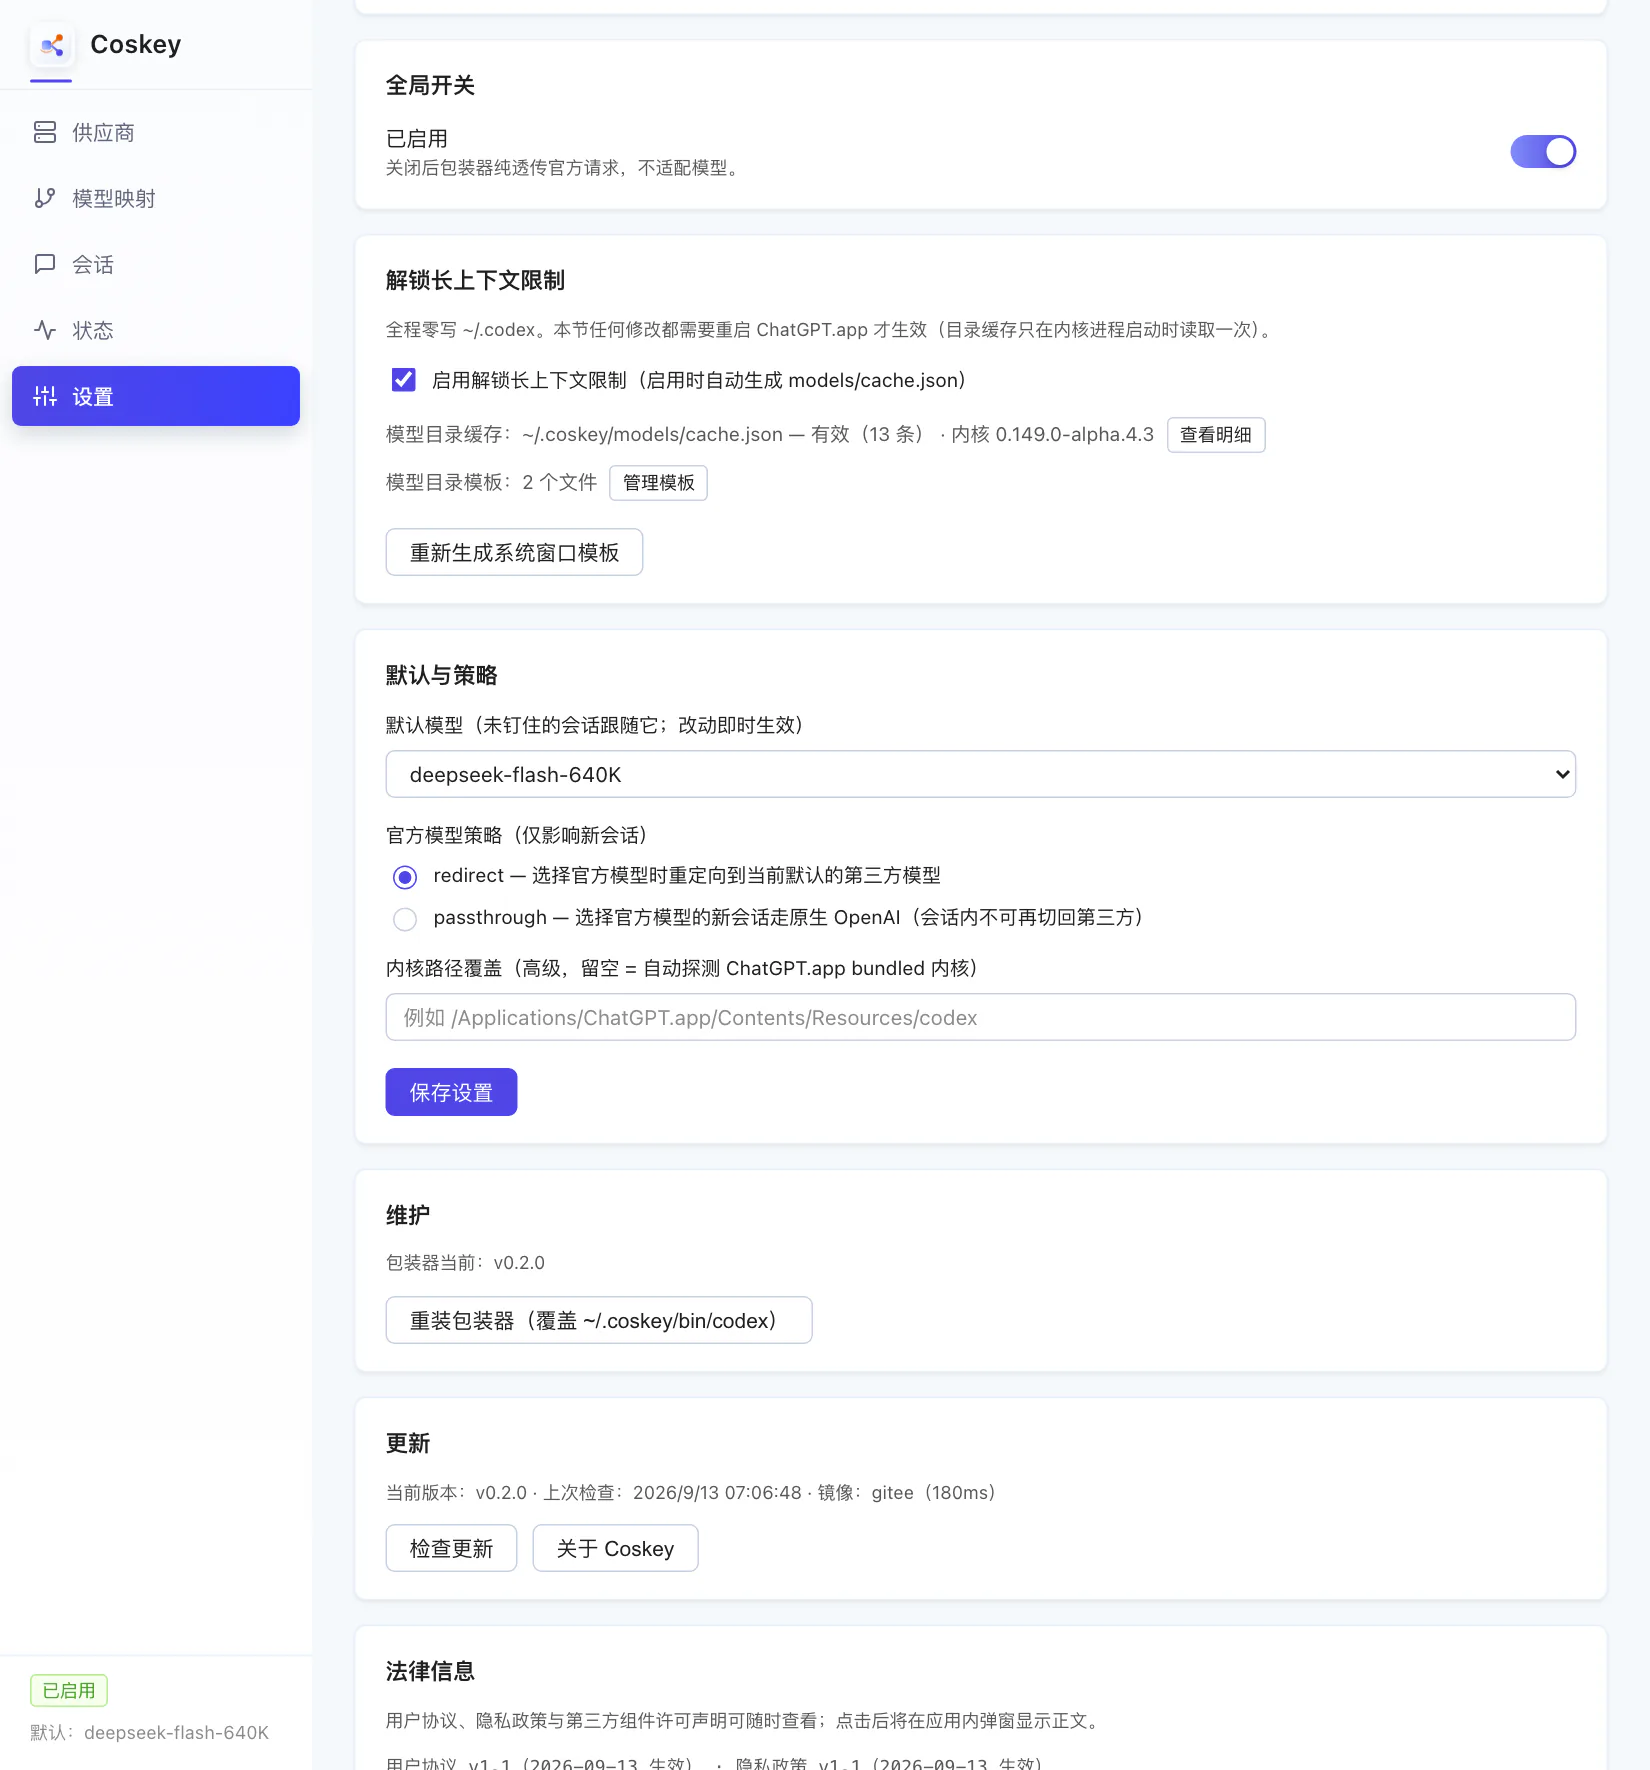
0. 先确认长上下文已解锁
窗口大于 272K 依赖「目录模式」:Coskey 启动内核时注入自己的模型目录缓存,让内核按目录条目
放宽窗口上限(对 ~/.codex 零写入)。默认已启用,进「设置」页确认即可:
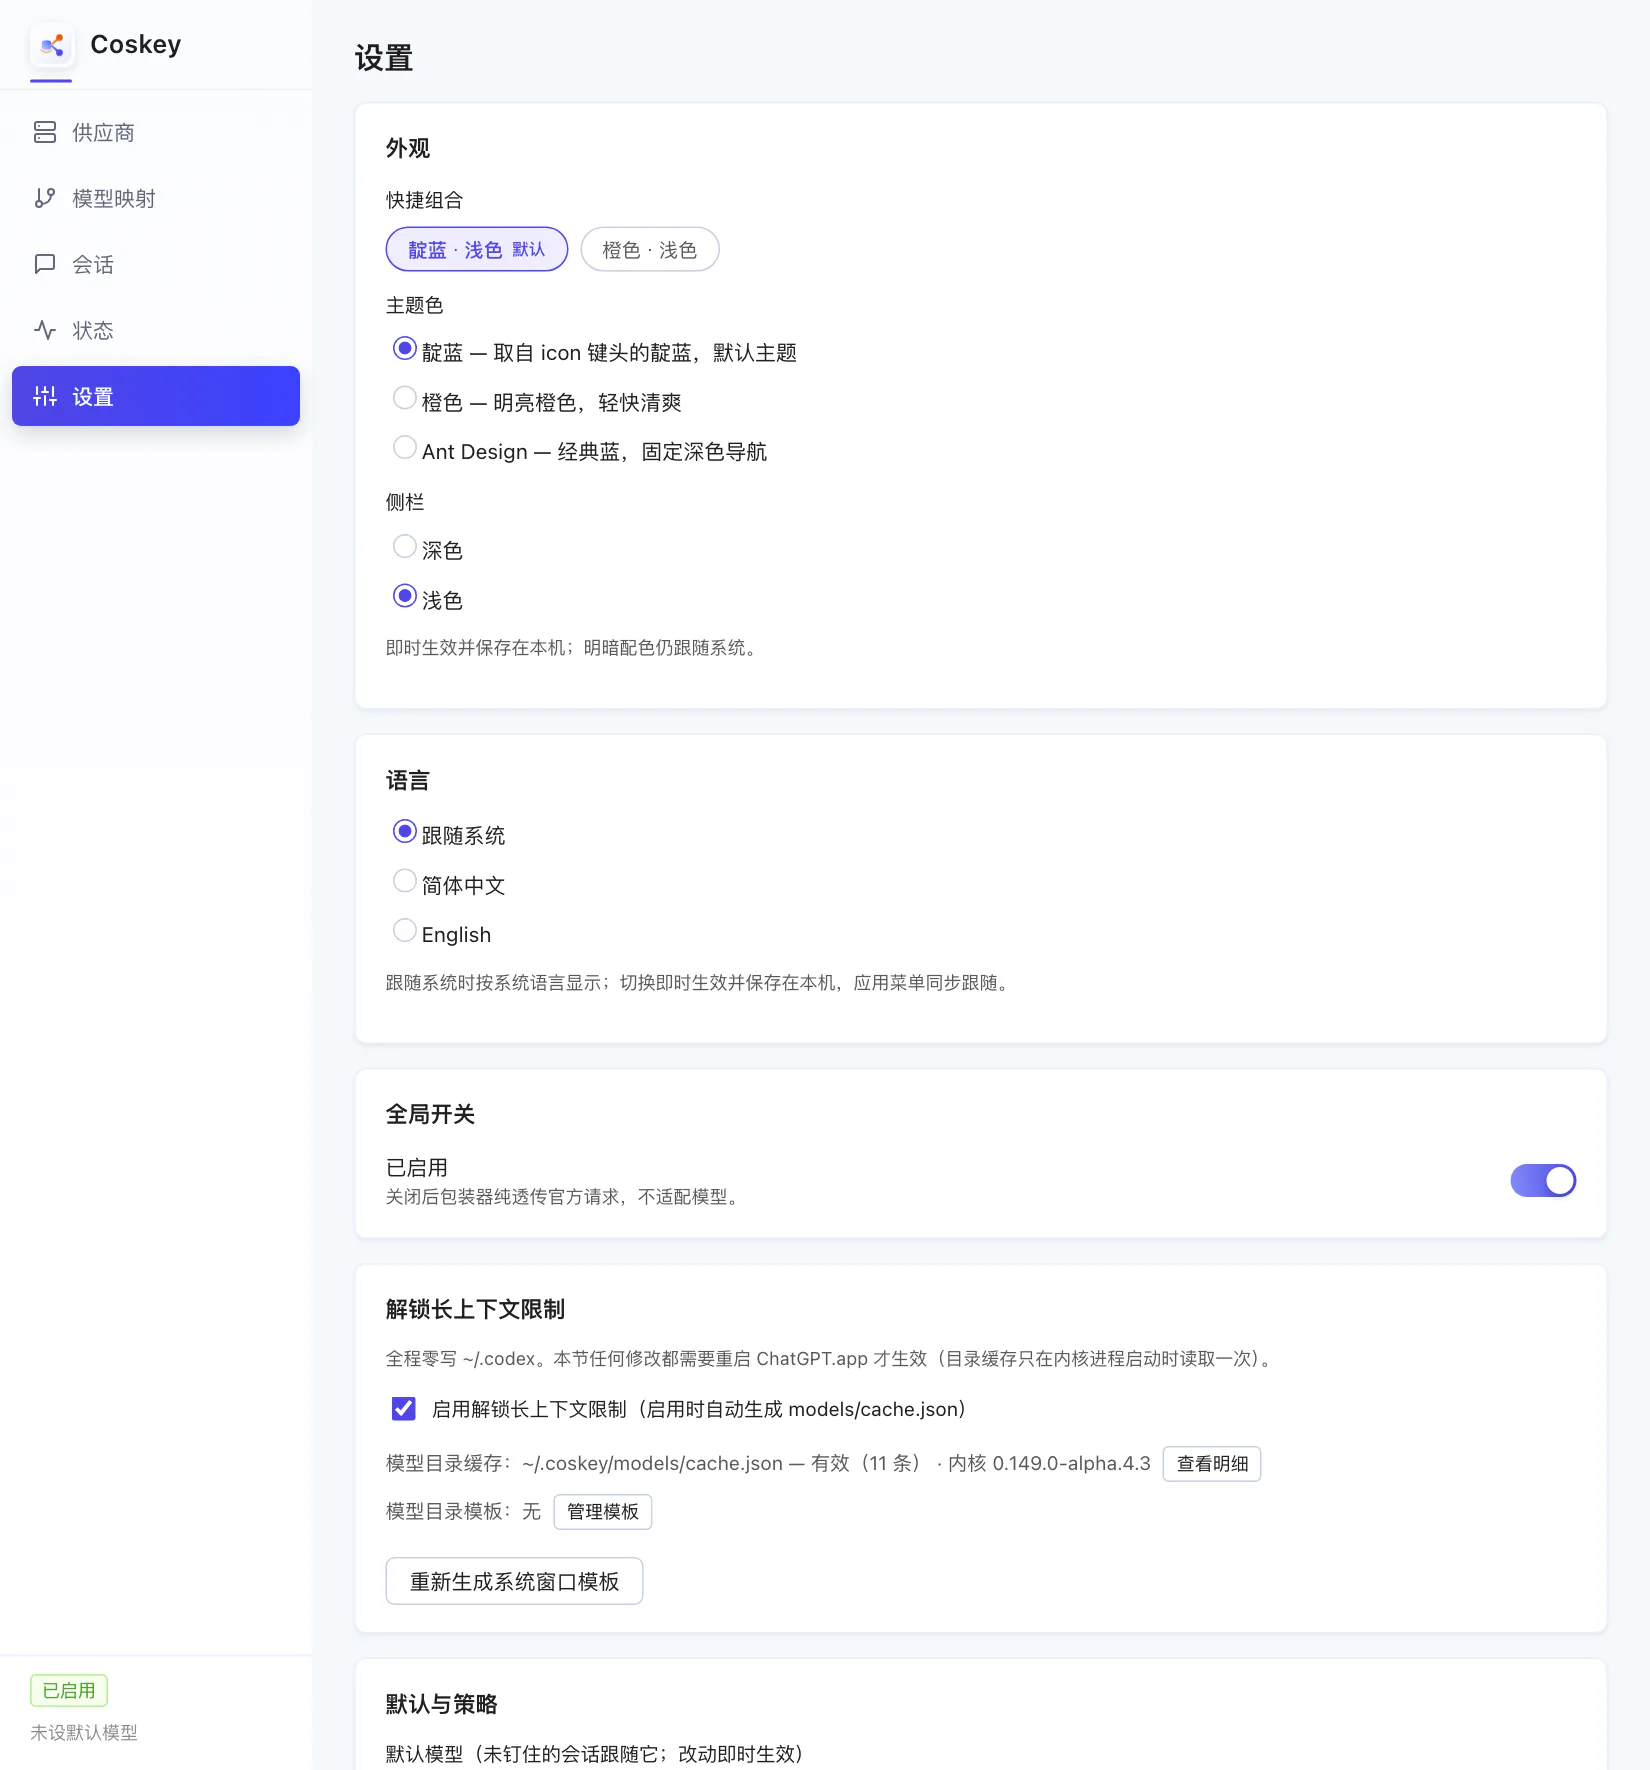
目录缓存只在内核启动时读一次——所以改完要重启 ChatGPT.app。
1. 新增映射
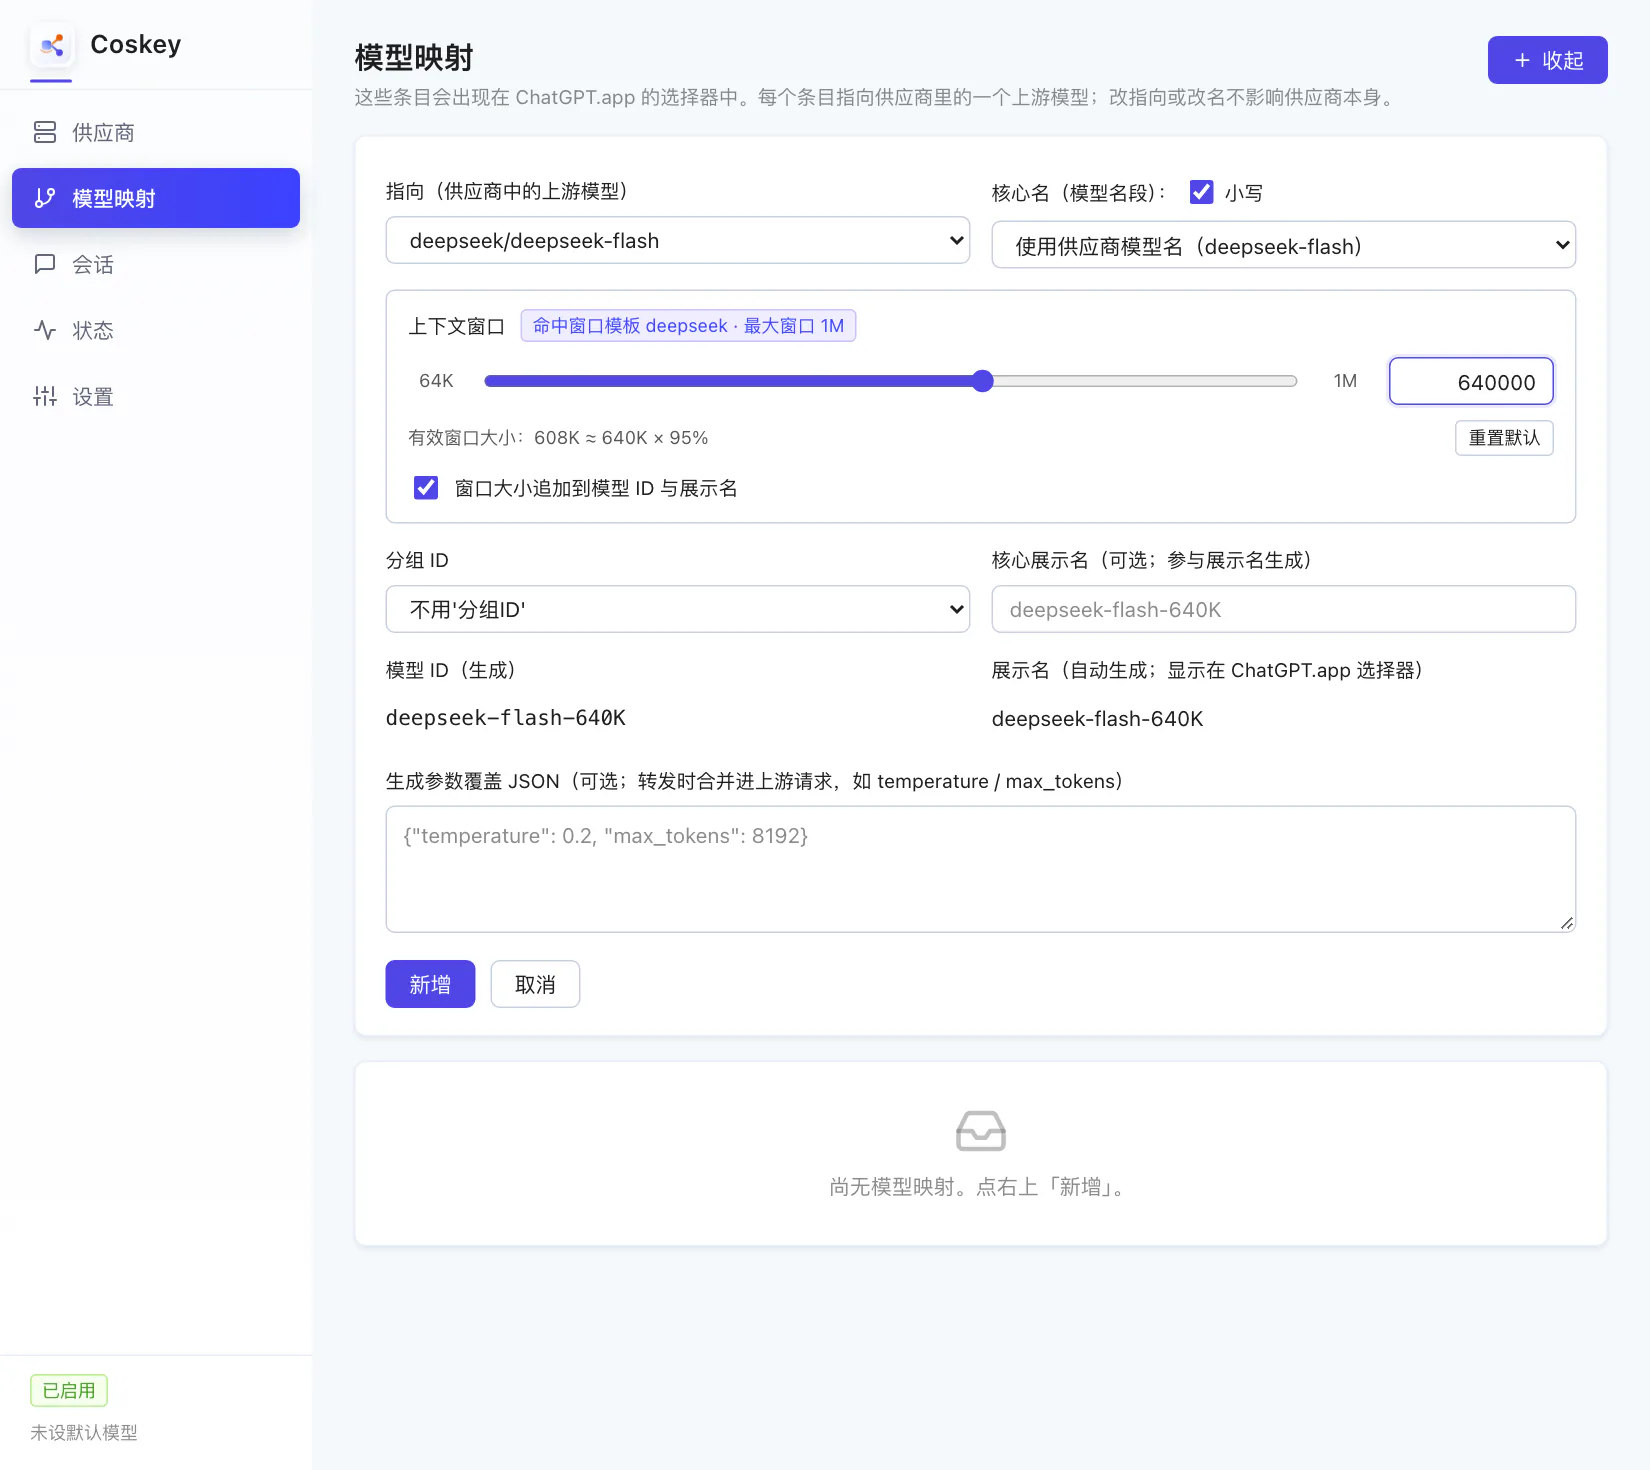
点右上「新增」,在「指向」里选上游模型:
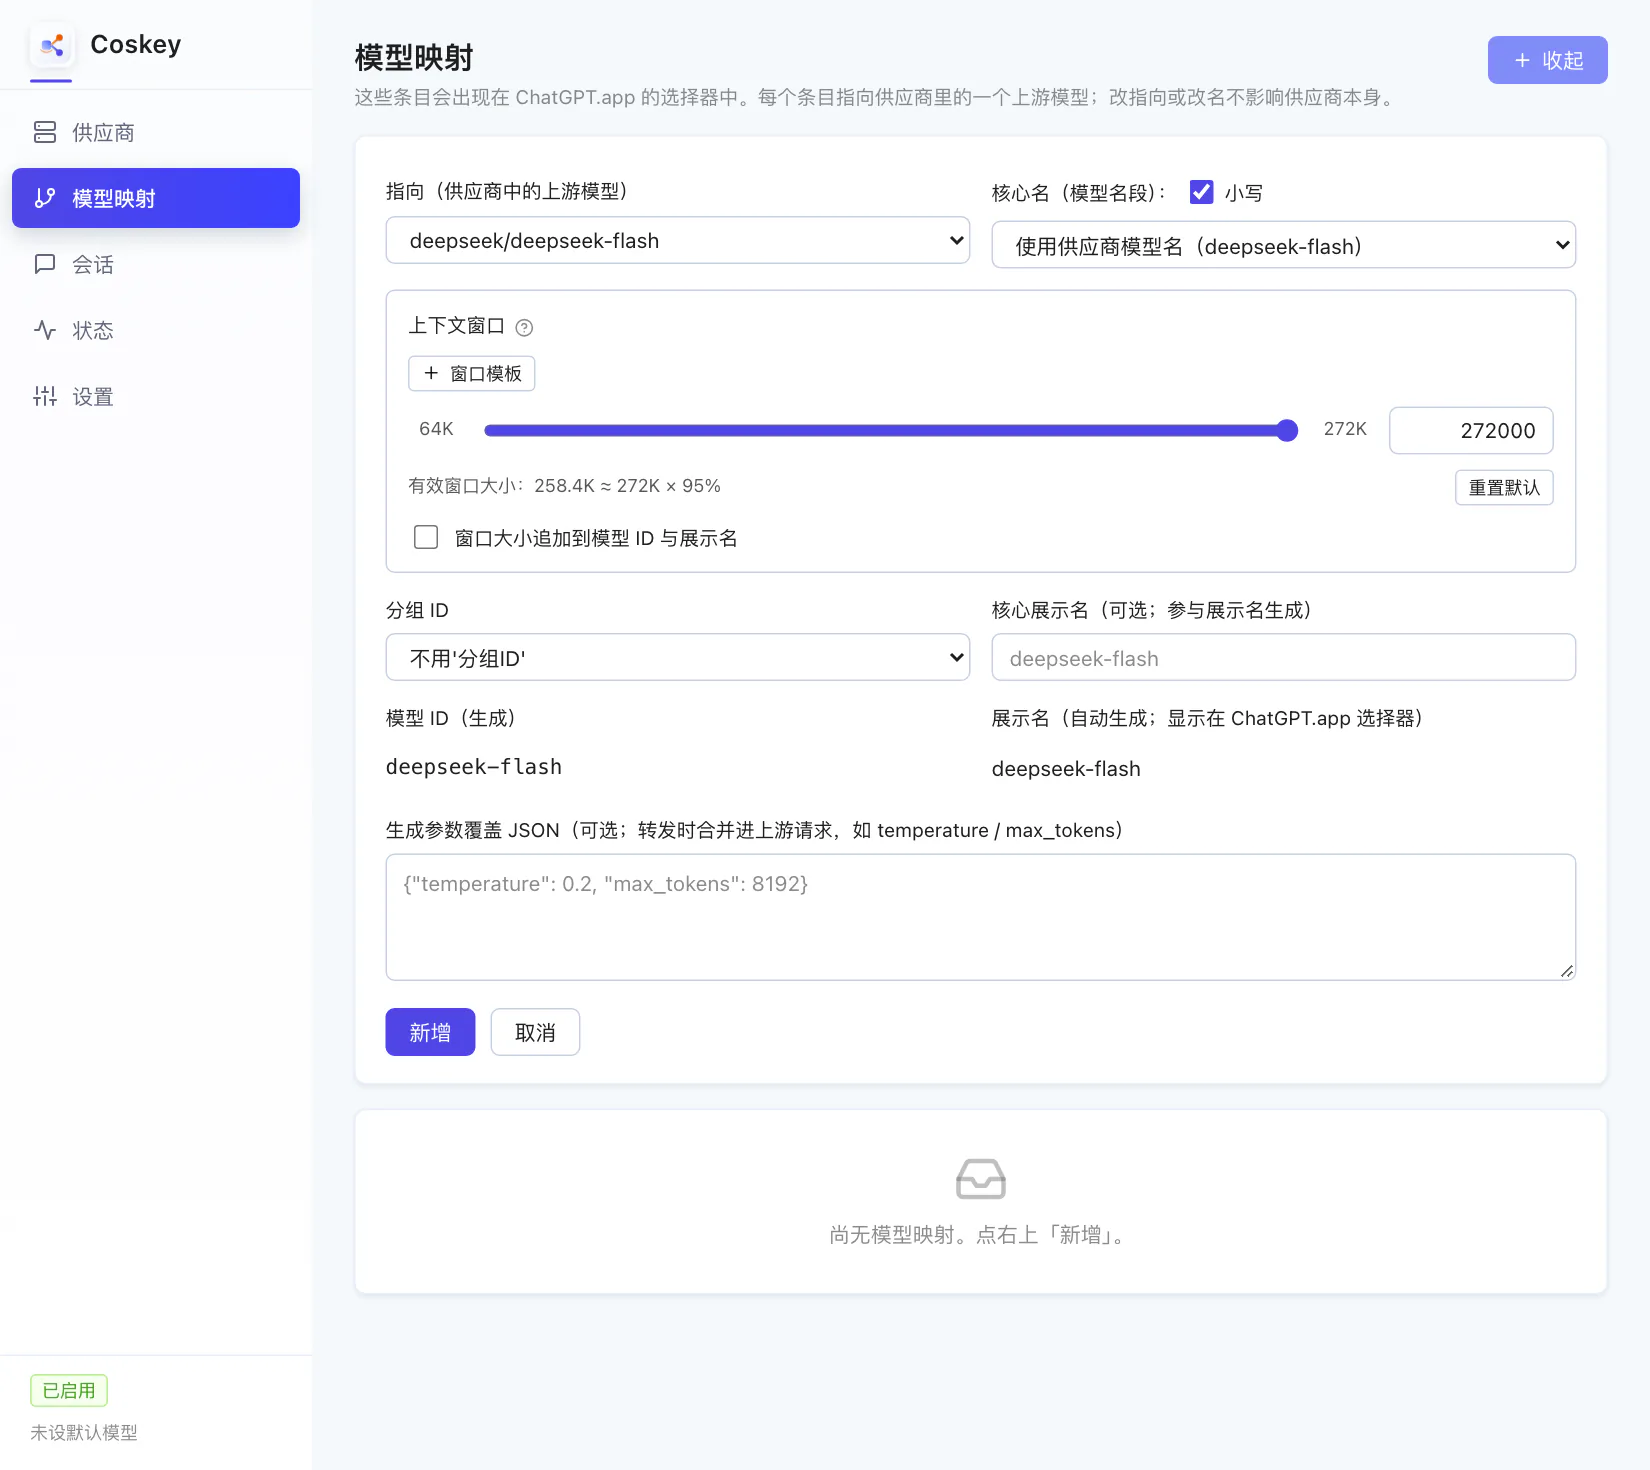
- 指向:目标上游模型;
- 核心名(模型名段):默认取上游模型名的末段并转小写;
- 分组 ID:可选「不用分组 ID」得到裸名 id,或用「供应商名」加命名空间;
- 上下文窗口:见下一节。
2. 配上下文窗口
内核按名字匹配窗口:应用模型 id 命中某条目录条目,就用那条条目的窗口设定。没命中时 只能吃回退默认值(272K),所以拖不动滑块时就该建一条模板。
点「+ 窗口模板」,模板名会按当前核心名预填:
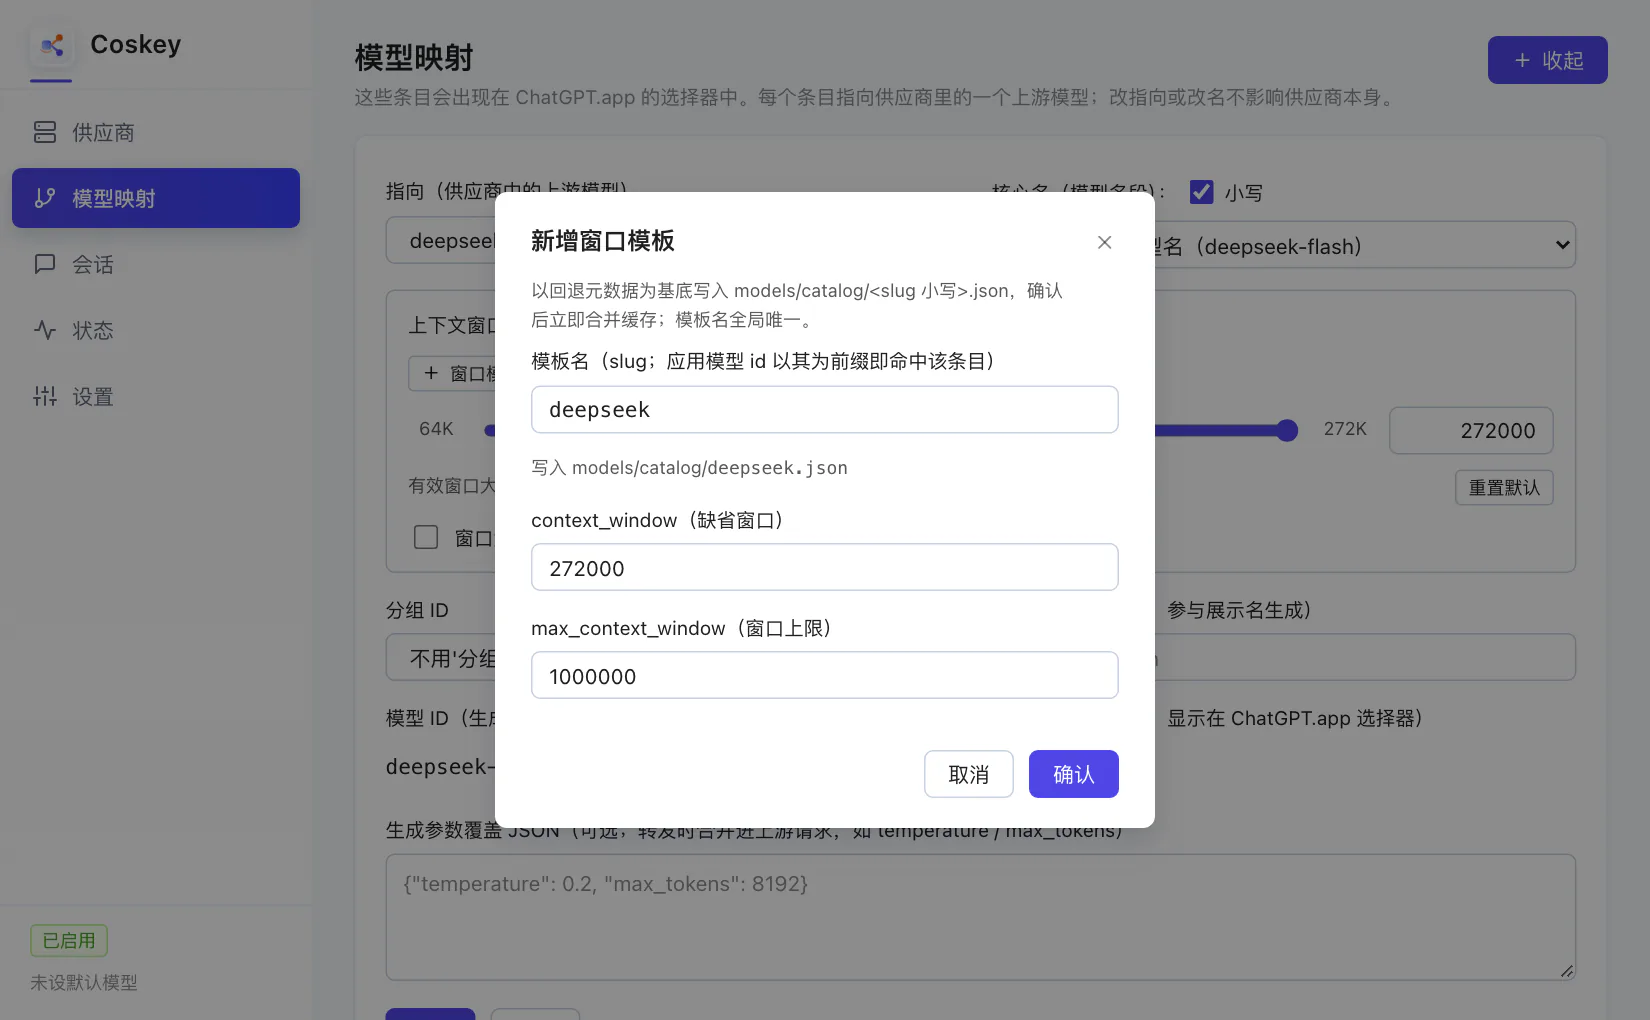
| 字段 | 含义 |
|---|---|
| 模板名(slug) | 应用模型 id 以它为前缀即命中(内核按最长前缀匹配) |
context_window |
缺省窗口:不覆盖时内核用它 |
max_context_window |
窗口上限:约束你注入的窗口值 |
确认后窗口区随即命中模板:
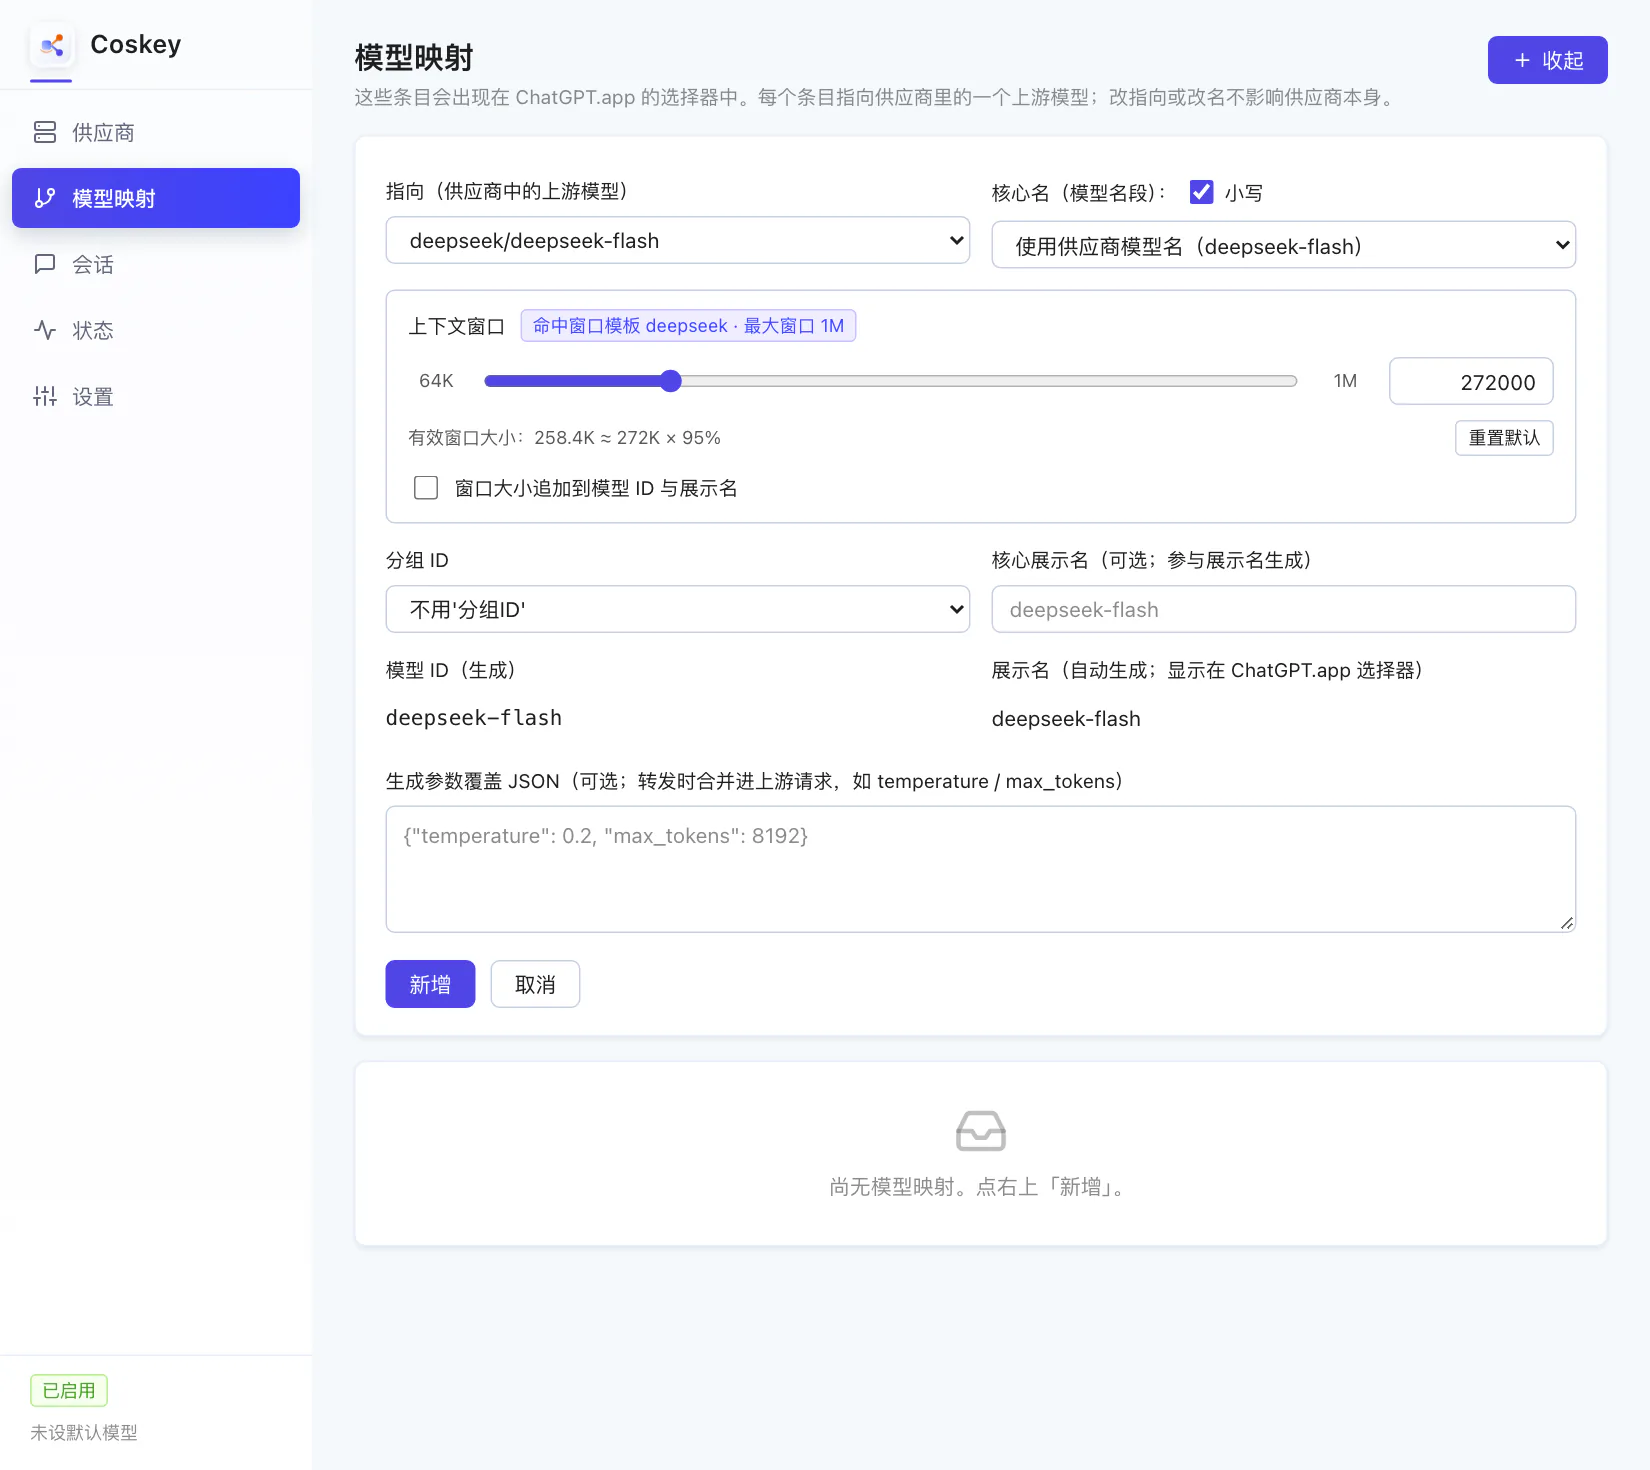
然后把窗口拖到想要的大小。勾选项「窗口大小追加到模型 ID 与展示名」会自动打开,id 与展示名 同步带上后缀:
两条要记住的规则:
- 有效窗口 = min(注入值, 目录上限) × 95%:填 640K,内核实际看到的是 608K,界面已算好显示;
- 窗口跟着名字走:id 就是内核眼里的模型名,所以按窗口分名(
-640K),不同窗口各有条目。
多级 id 的命中规则:内核先对整个 id 做最长前缀匹配,没命中就剥掉一层 namespace/ 再匹配。
改动窗口后如果活跃会话没跟上:窗口覆盖不可更新,会话列表会标「窗口待生效」,fork (ChatGPT.app 的「从聊天中继续」)、克隆会话或重启 app 后生效——真机实测见 在 ChatGPT.app 里使用 §3。
3. 生成参数(可选)
同一张表单底部的「生成参数覆盖 JSON」可以按上游 API 的参数名覆盖,例如
{"temperature": 0.2, "max_tokens": 8192}。这些参数只在转发到上游时合并,不影响其它模型。
翻译路径下 max_output_tokens 会自动映射为 max_tokens。
4. 设为默认
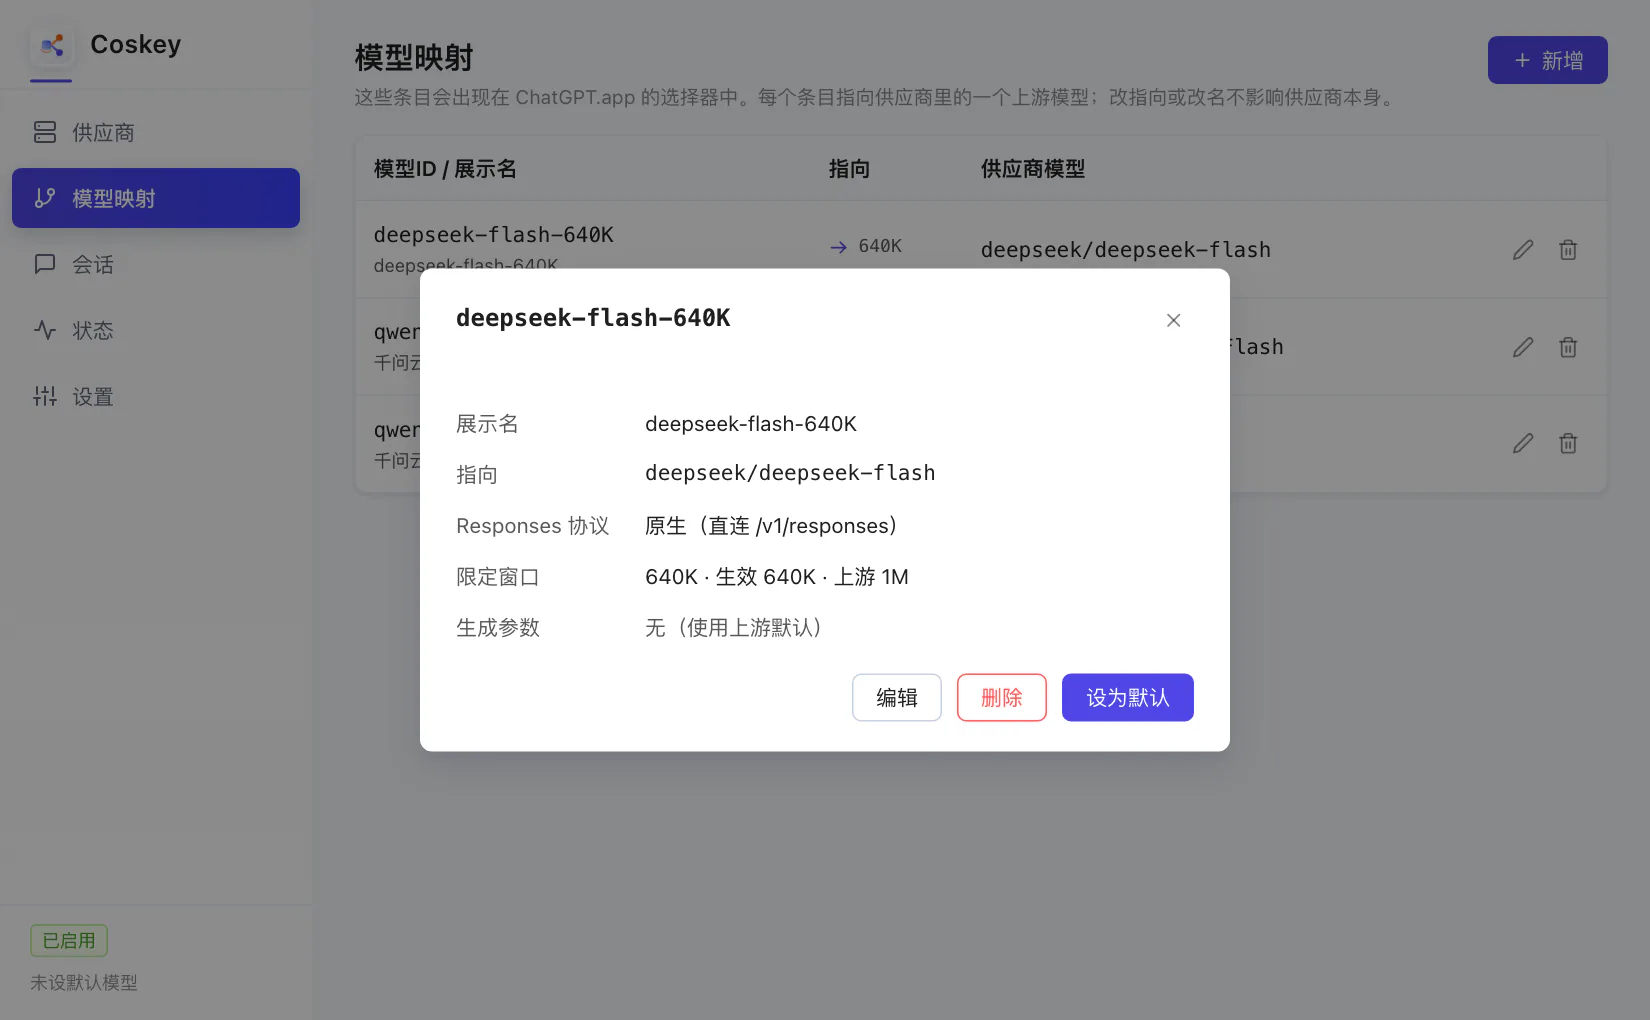
点任意一行打开详情,「设为默认」决定未钉住会话跟随哪个模型:
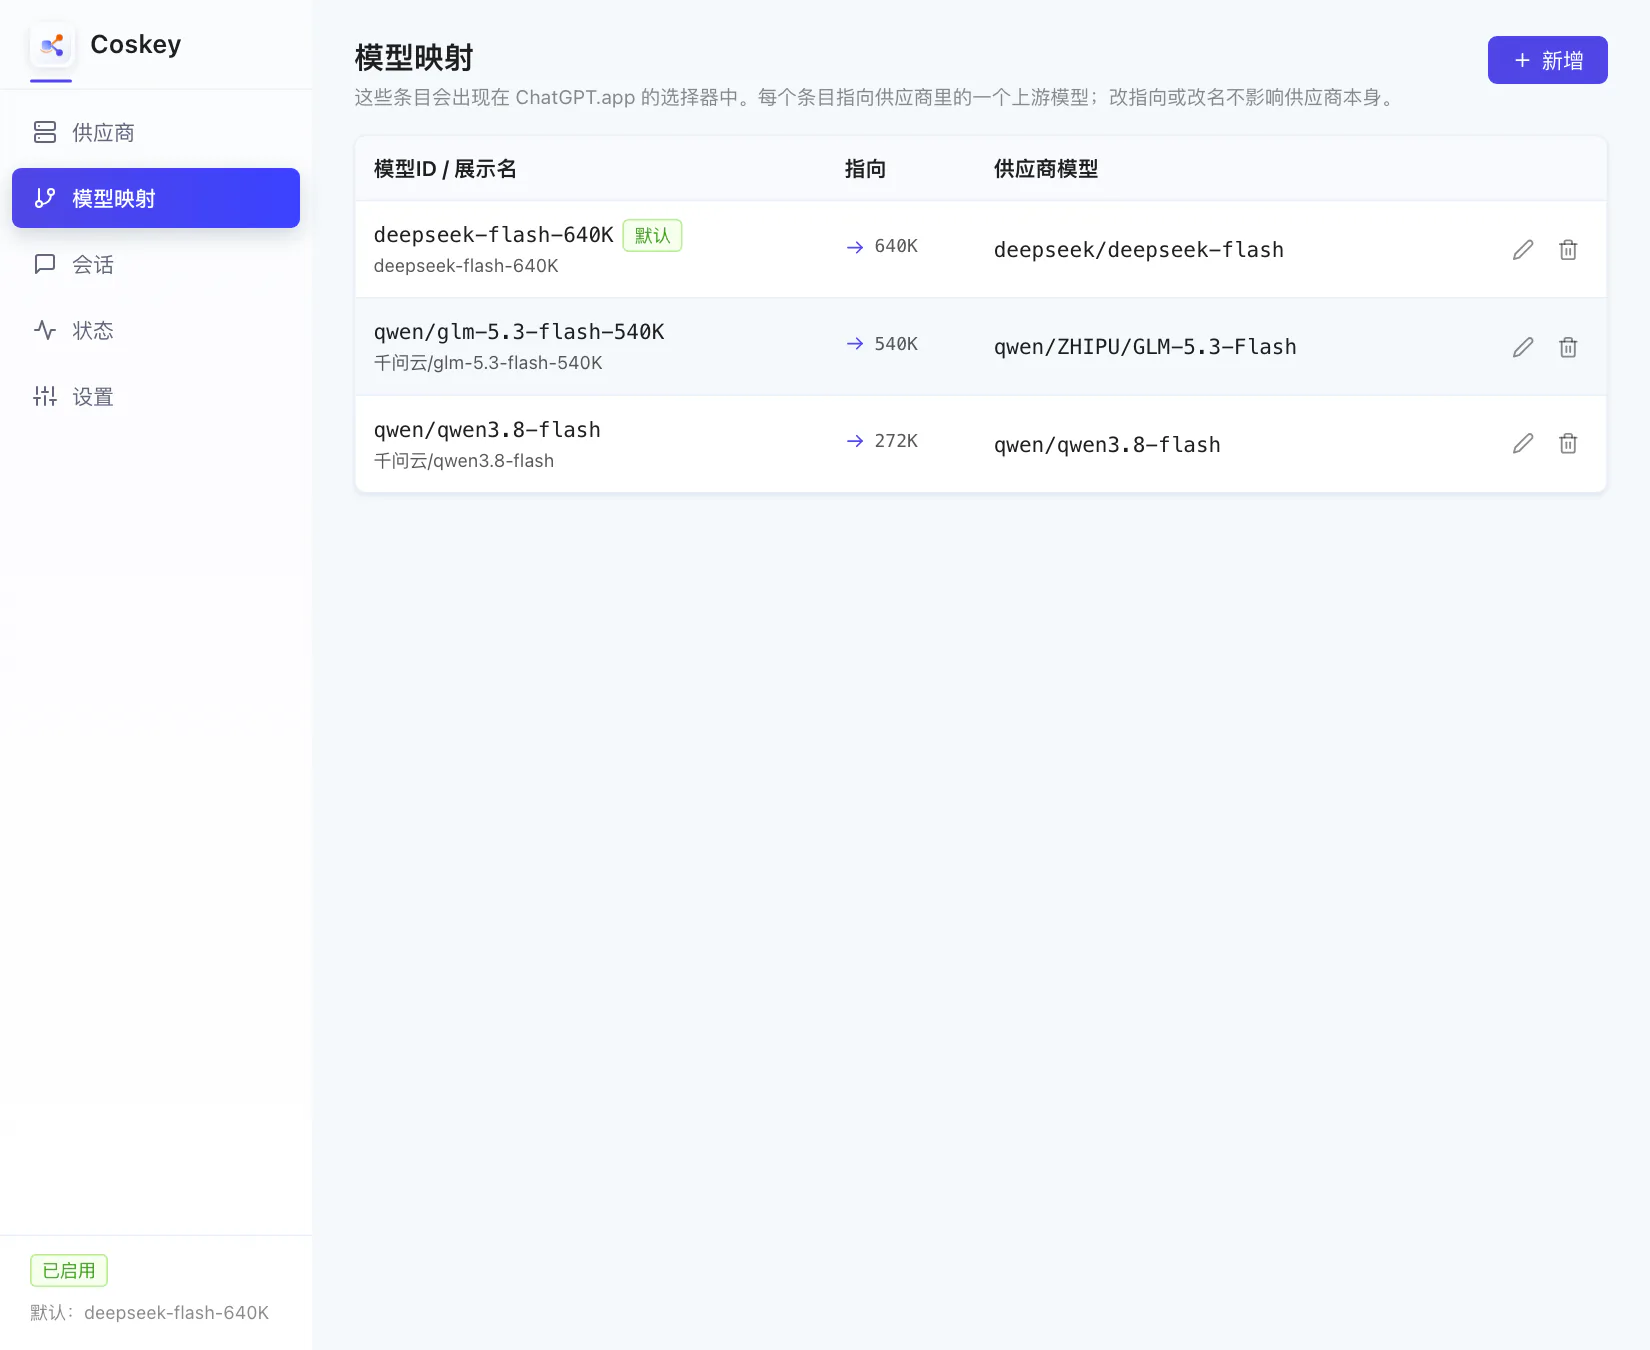
设为默认后列表里该行出现「默认」标记,左下角也会显示当前默认模型:
设置页的「默认与策略」是同一个开关:默认模型下拉即时生效;官方模型策略决定在
ChatGPT.app 里选官方模型时的行为——redirect 重定向到默认的第三方模型,passthrough
走原生 OpenAI。
下一步:在 ChatGPT.app 里使用。